安全批次救援混合編碼檔案的流程:我為何做這個工具
本文說明一套可落地的實務流程,用來吸收內部系統 CSV、Excel 匯出、Linux/Windows/資料庫輸出之間的編碼、換行與 BOM 差異。
前言
我做這個工具的理由很單純。 每次都要手動處理,真的很累。
內部系統 CSV、Excel 轉 CSV、以及 Linux/Windows/資料庫匯出的設定檔,來源一變,編碼、換行、BOM 就跟著變。
- 以為是 UTF-8,結果是 Shift_JIS
- 以為是 LF,結果是 CRLF
- 有些系統需要 BOM,有些系統遇到 BOM 會亂碼
每次靠人眼與經驗去猜測,已經到極限。 所以我做了這個工具:不管來源先接住,再依匯入端需求統一輸出。
現場真正麻煩的,不是一次亂碼
只壞一個檔案,通常都能補救。 真正痛的是 10 個、100 個檔案同時來,而且來源混雜。
更棘手的是,每個匯入系統的「正確格式」不同。
- 系統 A 只收 UTF-8(無 BOM)
- 系統 B 用 UTF-8(有 BOM)較穩
- 系統 C 以 Shift_JIS 為前提,UTF-8 看得懂但匯入失敗
此時「全部統一 UTF-8」這種通論沒有幫助。 真正需要的是能依用途安全重現的作業流程。
這個工具想解決什麼
核心只有三點:
- 接受任何來源
- 依匯入端規格轉換
- 批次處理也不放大事故
它不是炫技,而是降低維運摩擦的工具。
我實際使用的步驟
1. 先決定輸出規格
先定輸出,不先猜輸入。 固定三件事:
- 編碼(UTF-8 / Shift_JIS 等)
- 換行(LF / CRLF)
- BOM(有 / 無)
這裡若不固定,換一個人操作結果就會變。
2. 先拆成小批次
不要一開始就全量跑。 按系統、期間、檔案類型切分,先跑小批。
原因很務實:失敗時才能回滾。 全量一次成功很快,但失敗代價很大。
3. 固定條件後做批次轉換
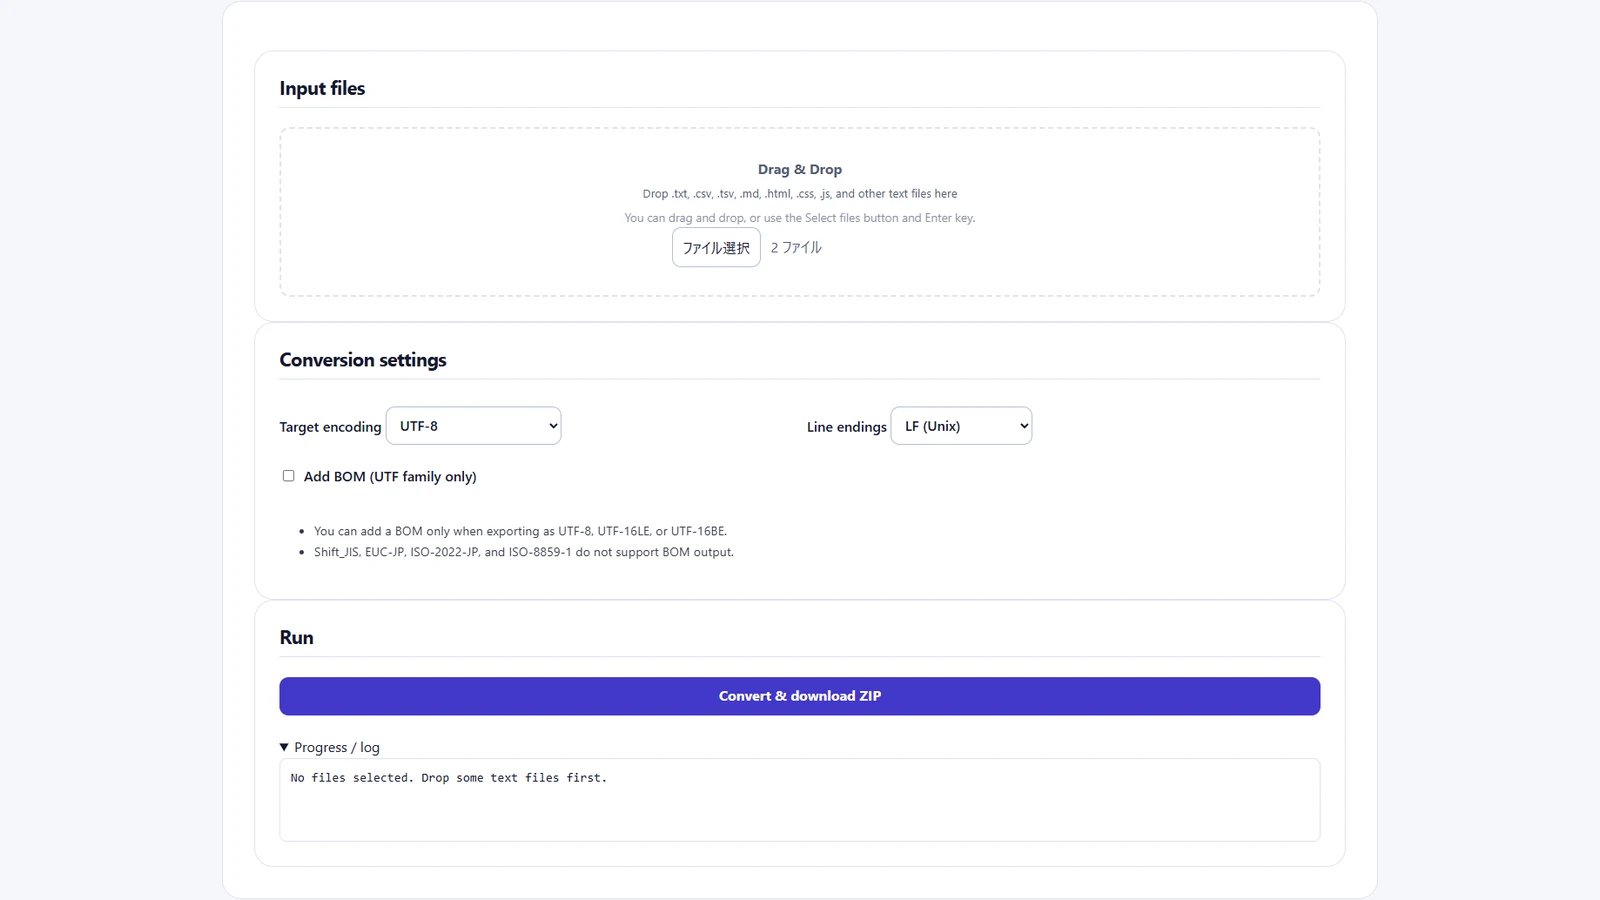
在 字元編碼轉換工具 中鎖定條件,不要中途改設定。 重點是每次都能用同一條件重跑。
orders-utf8.csv (UTF-8, LF, BOM) + orders-utf16.csv (UTF-16LE, CRLF, BOM) → UTF-8 / LF / BOM = none
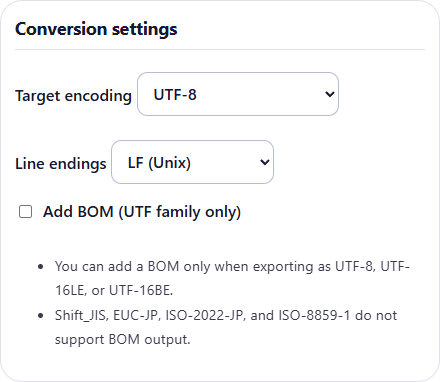
一次加入兩個檔案,選擇 UTF-8 與 LF (Unix),並取消勾選加入 BOM。
4. 儲存 ZIP 並核對記錄
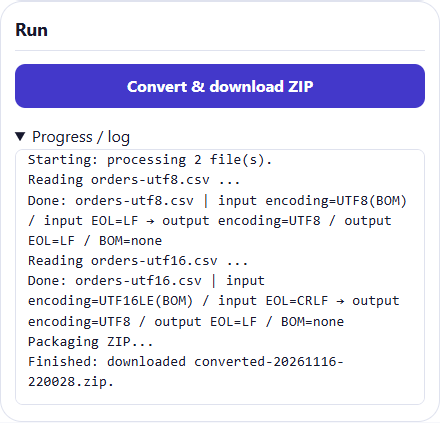
開始轉換。在記錄中確認各檔案偵測到的輸入編碼和換行格式,並確認兩個輸出都是 UTF-8、LF 且無 BOM。將 ZIP 解壓縮到另一個資料夾,檢查兩個檔案是否保留原名。如果有檔案被略過或發生錯誤,先查明原因再重試。
5. 不要只看「打得開」
「打得開就是 OK」常是事故起點。 至少檢查:
- 前後行數是否一致
- CSV/TSV 欄位數是否維持
�(替代字元)是否增加- 關鍵欄(ID/代碼)長度與字元型別是否維持
任何一項不過,就不要進匯入。
BOM 不是信仰,而是對端規格
現場裡 BOM 要不要的爭論其實意義不大。 只看對端系統如何接收。
- 對端帶 BOM 較穩,就輸出帶 BOM
- 對端遇 BOM 會壞,就輸出無 BOM
比起「理論正確」,更重要的是「對端不壞」。 維運就是這樣。
這個工具的價值不在轉換本身
真正價值在兩點:
- 判斷不再因人而異
- 每次檢查成本下降
編碼事故無法保證絕對歸零。 但可以停止重複同一類事故。 所以我準備了這個工具:先接住,再按用途穩定地還回去。
結論
這不是理想論工具。 它是為了消滅現場反覆出現的「麻煩編碼調整」。
接收不同來源檔案,依匯入規格對齊編碼、換行與 BOM,再輸出。 把這條流程機械化,維運就會輕鬆很多。
處理亂碼不該靠意志力。 應落成可重現流程,讓任何人都得到相同結果。 做到這一步,才稱得上「安全批次救援」。